發生了什麼事
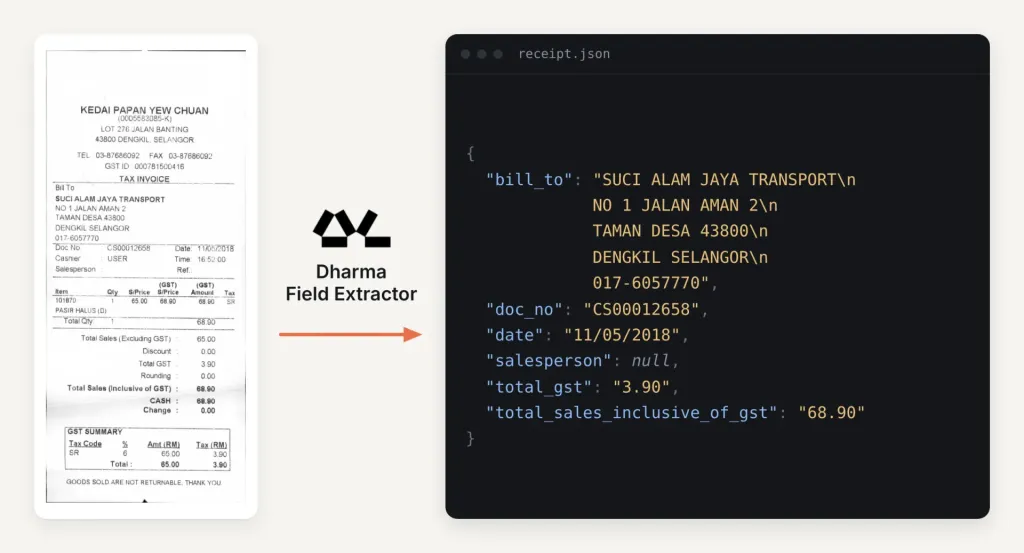
Hugging Face 最近推出了 Dharma Field Extractor,這是一個全新的 AI 模型,專門設計用於從各類文件中提取結構化數據。該模型的核心特點是能夠根據用戶要求的字段,將提取的數據以 JSON 格式輸出。這一技術的推出,對於需要高效數據處理的企業尤其重要,因為它能顯著降低數據處理的成本和時間。
重點摘要
- 模型規模:Dharma Field Extractor 擁有 20 億個參數,專門針對文件數據提取進行優化,並在多個測試中表現優於其他主流模型。
- 功能強大:該模型能夠從各類文件中提取特定字段,無論是發票、醫療申請表還是合約,並以結構化的 JSON 格式輸出。
- 靈活性:用戶可以選擇開放式請求或指定結構,模型能根據文件內容自動識別並提取所需字段。
- 成本效益:與其他主流模型相比,Dharma Field Extractor 的運行成本低至 6 倍至 147 倍,這使得其成為企業數據處理的經濟選擇。
- 訓練數據:模型基於多種語言和文件類型的訓練數據進行優化,涵蓋了英語、葡萄牙語及其他語言,確保了其廣泛的應用能力。
來源事實整理
| 特徵 | 詳情 |
|---|---|
| 模型名稱 | Dharma Field Extractor |
| 參數數量 | 20 億 |
| 輸出格式 | JSON |
| 主要功能 | 提取特定字段 |
| 運行成本 | 每小時 $2.24 |
| 訓練數據來源 | 多語言、多類型文件 |
影響分析
Dharma Field Extractor 的推出對香港品牌的內容生產、SEO、GEO/AI Search 及網站流量產生了深遠的影響。首先,這個模型能夠幫助企業更高效地處理和管理數據,因此提升內容的質素和準確性。其次,結構化的數據輸出能夠增強網站在搜尋引擎中的可見度,特別是在 AI 搜尋日益普及的背景下,這將有助於品牌吸引更多的潛在客戶。
此外,Dharma Field Extractor 的低運行成本使得企業能夠以更經濟的方式進行數據處理,因此釋放資源用於其他市場推廣活動。這對於香港的中小企業尤其重要,因為它們通常面臨資源有限的挑戰。透過這個模型,這些企業可以在不增加成本的情況下,提升其數據處理能力和市場競爭力。
限制與注意事項
儘管 Dharma Field Extractor 提供了強大的功能,但在使用過程中仍需注意一些限制。首先,模型的準確性可能受到輸入文件質素的影響,低質素的文件可能導致提取結果不準確。其次,雖然模型支持多種語言,但在某些語言的處理上可能存在一定的局限性,特別是對於非主流語言的支持。
此外,企業在使用該模型時,需考慮到數據隱私和安全性問題,特別是在處理敏感文件時,必須確保遵循相關法律法規。
實作步驟
- 評估需求:企業應首先評估自身的數據處理需求,確定需要提取的字段和文件類型。
- 選擇合適的請求方式:根據需求選擇開放式請求或指定結構,確保模型能夠準確提取所需數據。
- 整合到現有系統:將提取的 JSON 數據整合到企業的數據管理系統中,以便進行後續處理和分析。
- 持續監測效果:定期檢查提取結果的準確性,並根據需要進行調整。
- 培訓團隊:確保相關團隊了解如何使用該模型,並能夠有效地應用於日常工作中。
Dharma Field Extract 常見問題
Dharma Field Extractor 是什麼?
Dharma Field Extractor 是一個能夠從各類文件中提取特定字段並以結構化 JSON 格式輸出的 AI 模型。
這個模型的主要功能是什麼?
該模型可以根據用戶的需求提取文件中的特定字段,無論是開放式請求還是指定的結構,並返回結構化的 JSON 數據。
Dharma Field Extractor 如何影響香港品牌?
這個模型能夠提升香港品牌的數據處理效率,改善內容製作流程,並增強 SEO 和 AI 搜尋的可見度。
Dharma Field Extract:總結與下一步
Dharma Field Extractor 的推出標誌著文件數據提取技術的一次重大進步。對於香港品牌而言,這不僅是提升數據處理效率的機會,更是增強市場競爭力的關鍵。企業應積極評估這一技術的應用潛力,並考慮將其整合到現有的數據管理流程中,以實現更高效的營運。
本篇由 AI 輔助整理公開新聞並經 trafficholic 觀點改寫。 如要落實策略,可以再了解 SEO 搜尋優化、GEO/AI Search 優化與AI 內容培訓。
資訊參考公開報道趨勢,內容經 trafficholic 重新編寫。原始來源:連結