發生了什麼事
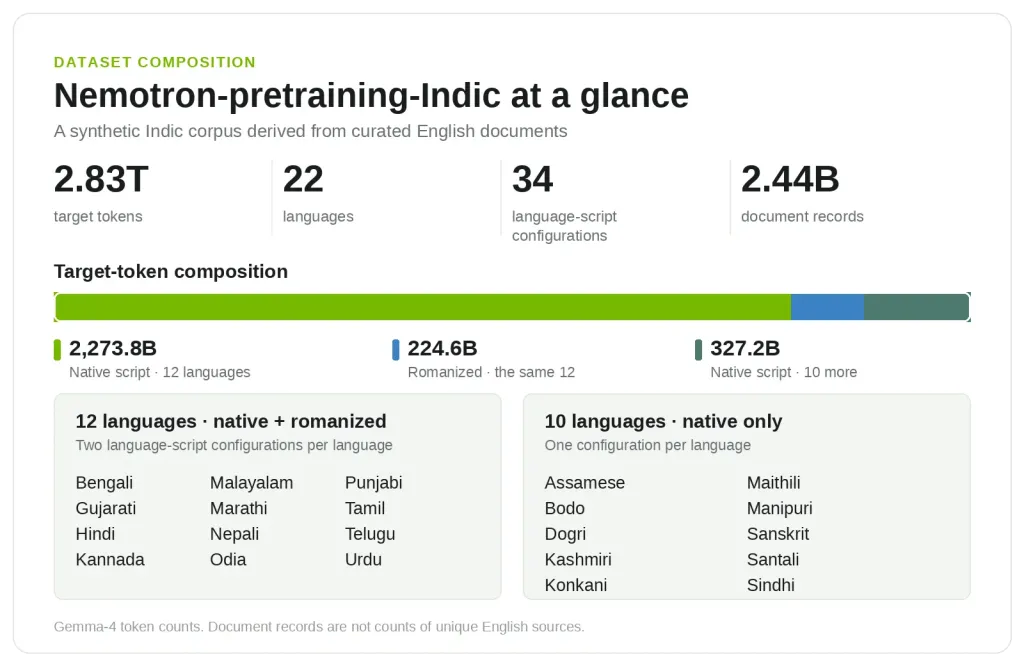
NVIDIA 與印度的 IIT Madras 聯手推出了 Nemotron-pretraining-Indic-v1,這是一個涵蓋 22 種印度語言的模型,擁有約 2.8 兆個標記。這一發布不僅是對印度語言技術的一次重大推進,還提供了一個開放的數據生成管道,旨在幫助開發者生成更多的印度語言數據,這對於香港品牌尤其重要,因為它們可以利用這一資源進一步拓展其在印度市場的影響力。
重點摘要
- 模型名稱:Nemotron-pretraining-Indic-v1,包含 2.8 兆個標記。
- 語言範圍:涵蓋 22 種印度語言,這些語言是印度憲法中列出的官方語言,服務於近 12 億人口。
- 開放數據生成管道:提供完整的生成流程,包括提示、LLM 工作流及質素檢查,開發者可根據自身需求進行調整。
- 數據來源:結合了來自網頁文本、數學、代碼和問題回答的資料,並確保每個生成的文本都能追溯到原始文檔。
- 質素控制:使用多維質素指標(MQM)來評估翻譯質素,確保生成文本的準確性和流暢性。
來源事實整理
| 項目 | 詳細資訊 |
|---|---|
| 模型名稱 | Nemotron-pretraining-Indic-v1 |
| 標記數量 | 2.8 兆個 |
| 語言數量 | 22 種 |
| 數據生成管道 | 開放式,支持自定義 |
| 質素評估標準 | 多維質素指標(MQM) |
影響分析
這則消息對香港品牌的內容生產、搜尋引擎優化(SEO)及網站流量有著深遠的影響。首先,香港品牌可以利用 Nemotron-pretraining-Indic-v1 生成的數據來建立高質素的內容,特別是在針對印度市場的推廣活動中。這將有助於提升品牌在印度的可見度,並吸引更多的潛在客戶。
其次,因應 AI Search 和 GEO 的發展,香港品牌需要關注如何將這些生成的內容優化,以提高其在搜尋引擎中的排名。使用這些語言生成的內容,品牌可以針對特定的關鍵字進行優化,進一步提升其 SEO 效果。
此外,這一技術的開放性意味著香港品牌可以根據自身需求進行調整和改進,因此提高其內容的針對性和有效性。這不僅能夠提升網站流量,還能改善用戶體驗,增加用戶的黏性。
限制與注意事項
儘管 Nemotron-pretraining-Indic-v1 提供了大量的數據和資源,但在使用時仍需注意以下幾點。首先,生成的數據雖然經過質素檢查,但仍可能存在一定的錯誤或不準確性,品牌在使用這些數據時應進行必要的審核和調整。
其次,開發者在使用開放數據生成管道時,需確保遵循相關的使用條款和授權協議,以避免潛在的法律問題。此外,對於特定的語言或文化背景,品牌在生成內容時應考慮到當地的文化差異和語言特點,以確保內容的適切性和有效性。
實作步驟
以下是香港品牌可以採取的幾個可執行步驟,以利用 Nemotron-pretraining-Indic-v1 提升其內容生產和 SEO 效果:
- 開始使用 Nemotron-pretraining-Indic-v1 生成的數據,建立針對印度市場的內容,並確保內容符合當地文化和語言特點。
- 進行關鍵字研究,針對生成的內容進行 SEO 優化,提升在搜尋引擎中的排名。
- 使用社交媒體推廣生成的內容,增加品牌在印度市場的曝光率。
- 定期評估生成內容的效果,根據數據分析進行調整,以提高用戶參與度和轉化率。
- 考慮與當地的內容創作者或專家合作,進一步提升內容的質素和針對性。
FAQ 區
Nemotron-pretraining-Indic-v1 具備哪些功能?
該模型涵蓋 22 種印度語言,提供 2.8 兆個標記,並開放數據生成管道,支持用戶自定義數據生成。
如何使用 Nemotron-pretraining-Indic-v1 進行內容創作?
用戶可以直接使用該模型生成的數據,或根據自身需求調整生成流程和質素檢查。
這項技術對香港品牌的影響是什麼?
香港品牌可透過利用該模型生成的數據,提升其在印度市場的可見度和內容質素,進而增加網站流量和 SEO 效果。
NVIDIA:總結與下一步
NVIDIA 推出的 Nemotron-pretraining-Indic-v1 不僅為印度語言技術的發展提供了新的資源,還為香港品牌進一步拓展印度市場提供了機會。透過利用這一模型生成的數據,品牌可以提升其內容質素,增強 SEO 效果,並最終提高網站流量。香港品牌應積極探索這一新技術,並根據自身需求進行靈活應用。
本篇由 AI 輔助整理公開新聞並經 trafficholic 觀點改寫。 如要落實策略,可以再了解 SEO 搜尋優化、GEO/AI Search 優化與AI 內容培訓。
資訊參考公開報道趨勢,內容經 trafficholic 重新編寫。原始來源:連結